

لا تنسوا أهلنا من صالح الدعاء,اللهم إنّا استودعناك اياهم، اللهم كُن عوناً لهم، اللهم انصرهم واحفظهم. 🇵🇸 🇸🇩
أهلًا وسهلًا بكم في العدد 110 من النشرة الأسبوعية لاقرأ-تِك 🚀
سواء كنت مهندس برمجيات مبتدئ أو محترف، فنشرتنا هتساعدك على مواكبة أحدث تطورات عالم البرمجة بمواضيع جديدة كل أسبوع، هتلاقى كمان محتوى عملي بيشمل أفضل الممارسات، ونصائح مفيدة، وترشيحات لمقالات مختارة من اقرأ-تِك.
أسبوع مجنون جديد في الـ AI: ولكن عن ال Open Weight Models 🔥
الأسبوع دا كان في إعلانات عن نزول Open Weight Models جديدة في أوروبا وأمريكا في مناورة شقية عشان الصين مستحوذة علي هذا الموضوع، ولكن الأسبوع دا مش بس هنتكلم عن الأخبار لكن هنستفيض في موضوع ال Open Weight Models والفرق بينها وبين ال Open Source وهل فعلاً تستحق التجربة وال Hype حواليها؟ وهل هتشتغل علي اللابتوب الغلبان الشخصي اللي معانا خلونا نشوف 🤷♀️
🌟 مواضيع النشرة لهذا الأسبوع 🌟
Mistral Large & Beam From Reflection AI
Open-Weight Models - Worth a Developer’s Time, or Just Hype
Mistral Large & Beam From Reflection AI
Mistral Large 4 (اسم الدلع: Le Chonk 🐘)
شركة Mistral الفرنسية، اللي بتتعامل كأمل أوروبا في سباق الـ AI، كشفت يوم الثلاثاء 6 أكتوبر عن موديلها الجديد Mistral Large 4، وده أول إصدار كبير ليها بعد فجوة حوالي خمس شهور. الموديل ضخم فعلًا: حجمه تريليون باراميتر، والشركة بتقول إنه قوي بشكل خاص في الـ cyber والكود والتصنيع والفاينانس والـ multimodal.
وMistral بتقول إنه أقوى موديل open-weight اتعمل برّه الصين، وبفرق كبير. الشركة دربته على بنيتها التحتية في أوروبا، على مدار شهرين وباستخدام 4,000 جي بي يو Nvidia Grace Blackwell. بس خلي بالك من نقطتين. الأولى إنه لسه متأخر عن موديلات الـ frontier في مجالات زي الكود. والتانية إنه لحد دلوقتي مش open-weight فعليًا، والوصول ليه متاح بس عن طريق endpoint عام عليه.
📅 مواعيد الإتاحة: الـ preview متاح دلوقتي للمطورين وقيادات السيكيوريتي والجهات الحكومية، والإتاحة العامة يوم 27 أكتوبر، ومعاها نزول الأوزان بعد ما اختبارات الأمان تخلص.
Beam - Reflection AI
الأسبوع دا بنشوف Reflection AI شركة أمريكية مدعومة من Nvidia، اتأسست سنة 2024 على إيد اتنين باحثين سابقين في Google DeepMind، وجمعت حوالي 4.7 مليار دولار بتقييم 25 مليار قبل ما تنزّل أي منتج. يوم 5 أكتوبر أعلنت عن Beam، وده أول موديل ليها. Beam موديل MoE إجمالي باراميتراته 501 مليار، والنشط منهم في كل query بس 23 مليار، ومتخصص في البرمجة ومهام الـ agents. أقوى نقطة فيه هي الكفاءة: الشركة بتقول إنه بيجيب نفس أداء GLM-5.2 في اختبارات الـ reasoning المتقدمة، وبيستهلك موارد inference أقل بـ 3 لـ 4 مرات، وإنه بيقرّب من Qwen3.8-Max في الكود والـ agentic workflows. والشركة نفسها بتعترف إن Kimi K3 الصيني لسه أقوى منه في القدرات المطلقة. وفيه تحفظين لازم تعرفهم: ادعاءات الأداء دي محدش راجعها بشكل مستقل لسه، والموديل نصّي بس، مش multimodal.
📅 مواعيد الإتاحة: متاح حاليًا عن طريق waitlist، وبيعدّي آخر مراحل فحوصات الأمان. والشركة ناوية تنزّل الأوزان والتفاصيل التقنية الكاملة الشهر ده، وهيبقى متوزع عن طريق الـ hyperscalers والـ neoclouds ومتكامل مع مكتبات الـ open source من أول يوم.
طب يستاهلوا وقتك كمبرمج؟
لو استخدامك اليومي للـ AI هو إنه يساعدك تكتب كود: لأ، مش دلوقتي. الاتنين لسه ورا موديلات الـ frontier المقفولة في الكود، ومفيش داعي تغيّر أدواتك عشانهم.
لو بتبني منتج ومحتاج تشغّل موديل على سيرفراتك: يعني عندك قيود على خصوصية الداتا، أو بتحسب تكلفة الـ inference بالقرش، أو عميلك حكومي أو أوروبي. هنا الاتنين يستاهلوا جدًا. جرّبهم أول ما يبقوا متاحين على providers زي OpenRouter أو Hugging Face، من غير ما تستضيفهم بنفسك.وخلونا نستني أول benchmarks مستقلة قبل ما نتحمس لأن أرقام ال Benchmarks من الشركات بيكون جزء مش صغير منها تسويق!
Open-Weight Models - Worth a Developer’s Time, or Just Hype?
ماذا يعني الـ Open Weight، وما الفرق بينه وبين الـ Open Source؟
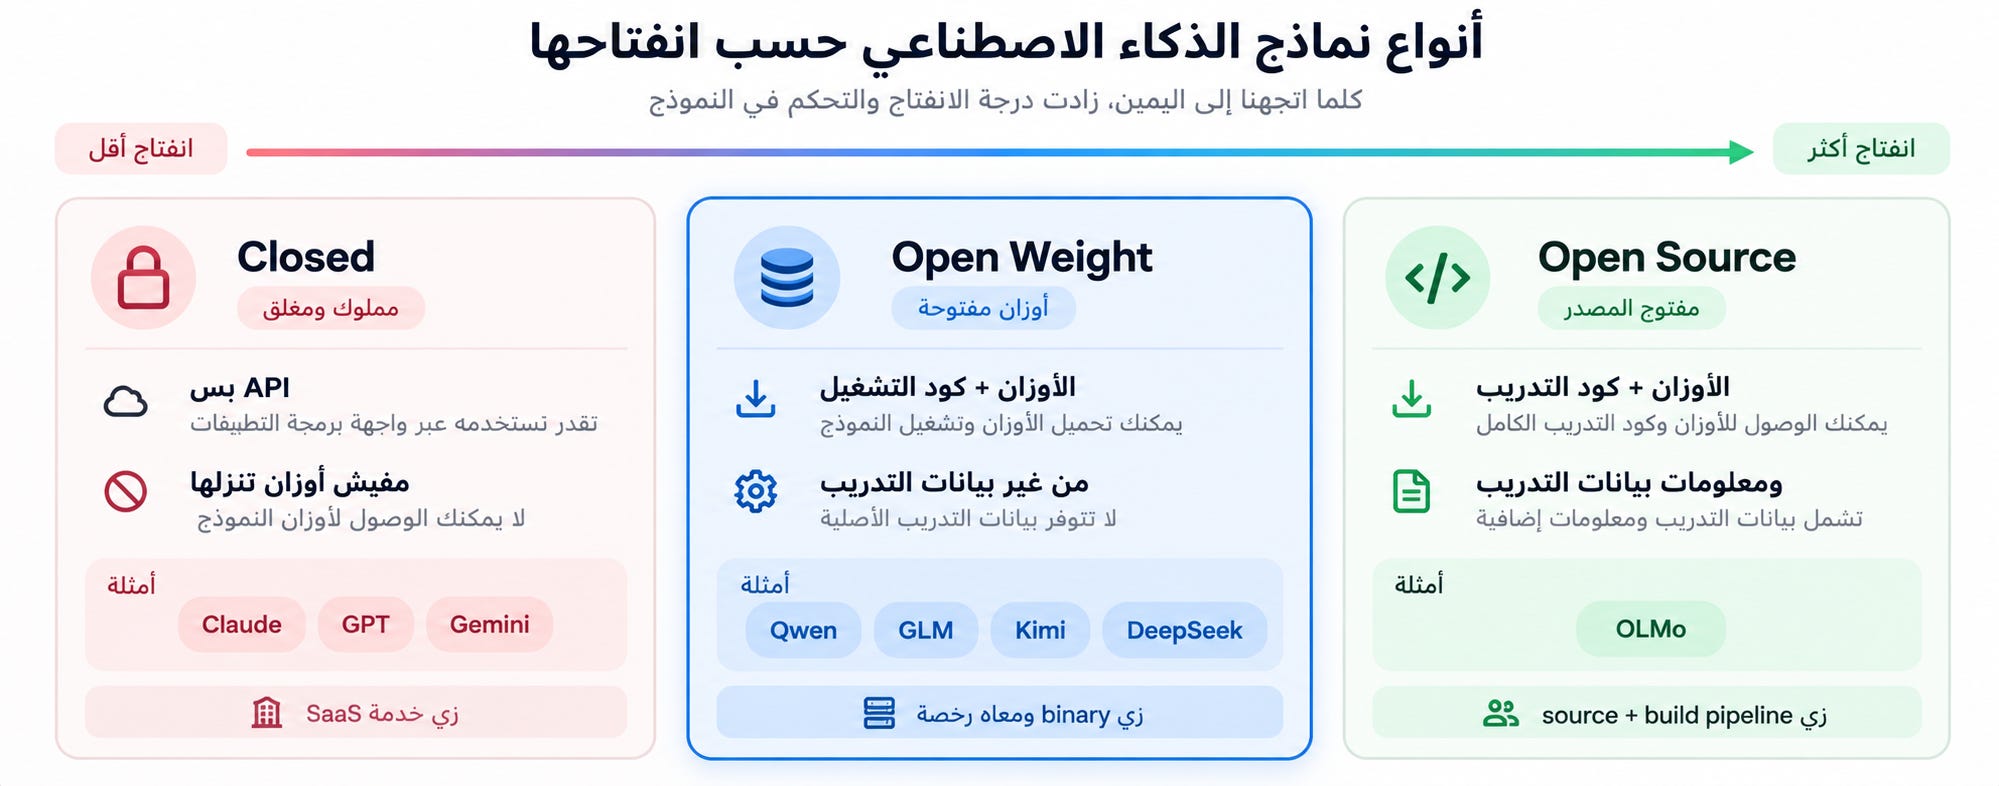
الموديل الـ Open Weight هو موديل الشركة نشرت أوزانه (weights): الملف اللي فيه مليارات الأرقام اللي الموديل اتعلمها. تنزله، تشغله على جهازك أو سيرفرك، وتعمله fine-tuning، من غير API ومن غير ما الكود بتاعك يخرج بره.
الـ Open Source بالمعنى الكامل حاجة أكبر. منظمة OSI نشرت تعريف رسمي (OSAID 1.0) في أكتوبر 2024، وبيشترط إنك تاخد الأوزان، وكود التدريب، ومعلومات كافية عن بيانات التدريب تخليك تعيد بناء موديل مكافئ.
التشبيه الأقرب لينا كمبرمجين: الـ Open Weight زي ما تاخد binary متكامل ومعاه رخصة استخدام. تشغله وتعدل عليه شوية، بس متعرفش اتبنى ازاي. الـ Open Source الكامل زي ما تاخد الـ source code والـ build pipeline كمان.
في نقطتين لازم تاخد بالك منها قبل استخدام ال Open Weights:
أغلب اللي بيتقال عليه “Open Source LLM” هو في الحقيقة Open Weight. حتى Artificial Analysis نفسها بتسمي الصفحة “Open Source Models” وبتكتب تحتها إن المقصود open weights.
رخصة الإستخدام مختلفة عن فكرة الانفتاح. رخصة MIT أو Apache 2.0 على الأوزان بتديك حرية الاستخدام التجاري، بس مبتخليش الموديل Open Source بتعريف OSI طول ما الكود والبيانات الخاصة بتدريب النموذج مش منشورين. وكذلك “مفتوح” مش معناها “اعمل اللي انت عايزه” كتير من الموديلات تحت رخص مختلفة فاقرا الرخصة قبل أي مشروع تجاري.
تستاهل تجربها وانت أصلًا شغال بـ frontier models؟
آه تستاهل، بس كإضافة جنب الـ frontier مش بديل ليه. ولكن قبل ما ندخل في الأرقام لازم تفرّق بين عالمين مختلفين تمامًا كثير مننا بيخلط بينهم ودا عشان نقرأ الأرقام صح:
الموديلات المفتوحة العملاقة (من 320B لحد 2.8T بارامتر): دي اللي بتنافس الـ frontier فعلًا. مبتشتغلش على لابتوب، وبتستخدمها عن طريق API من مزوّد.
الموديلات اللي بتدخل جهازك (لحد 30B–35B تقريبًا): أضعف بمسافة واضحة، بس مجانية وخاصة.
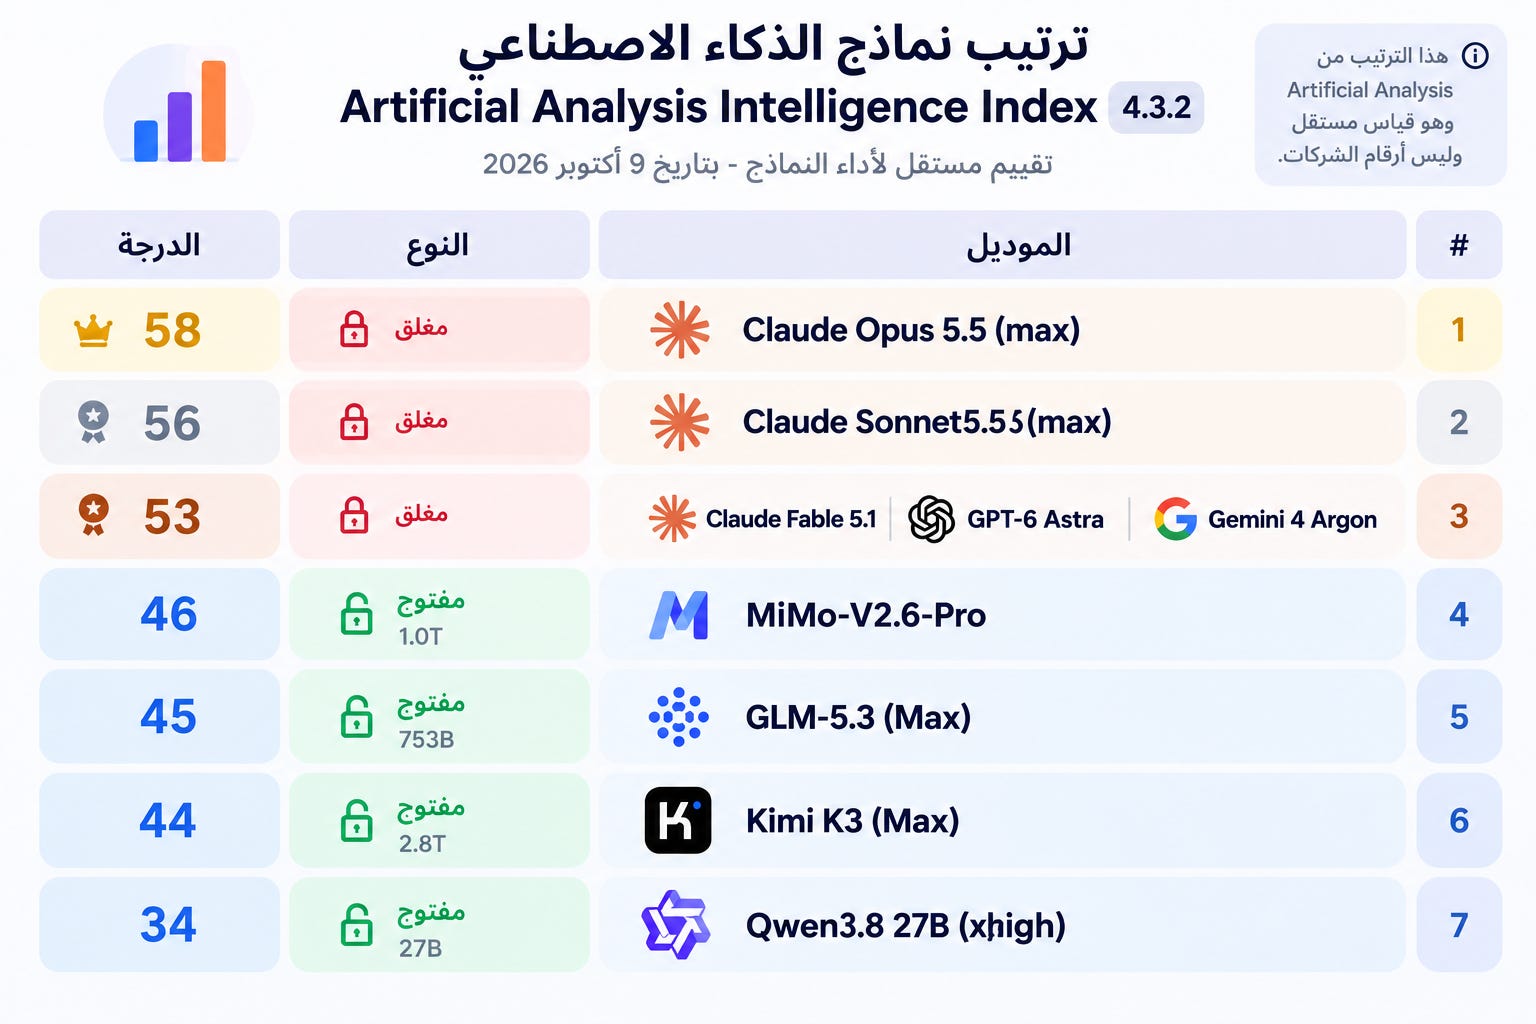
ده ترتيب Artificial Analysis Intelligence Index (إصدار 4.3.2) زي ما هو ظاهر يوم 9 أكتوبر 2026، وهو قياس مستقل مش أرقام الشركات:
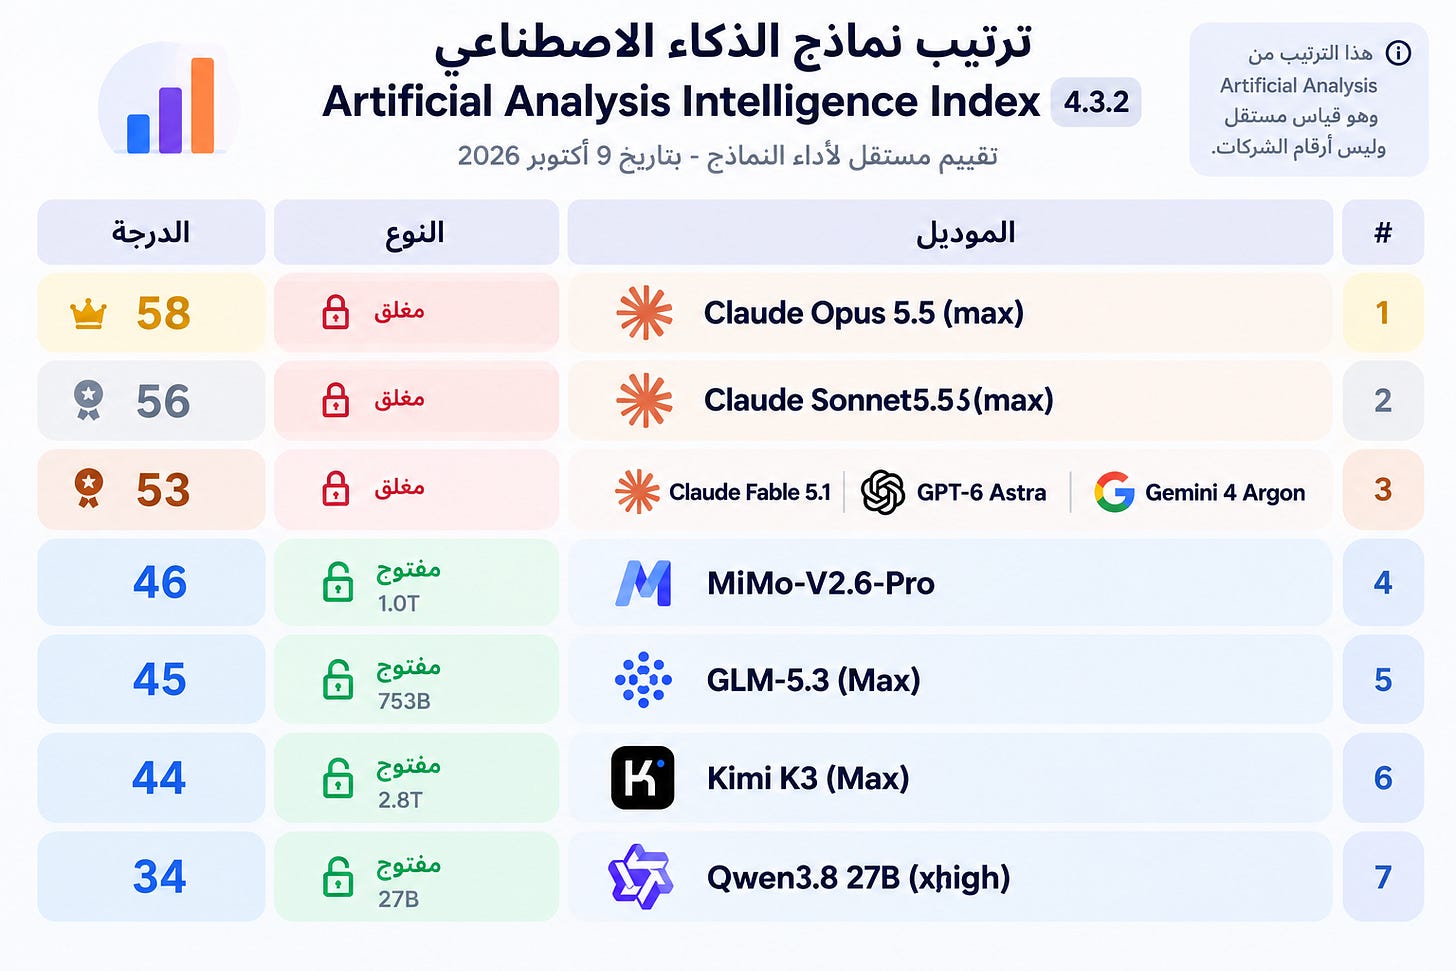
القراءة للترتيب: إن أحسن موديل مفتوح ورا أحسن موديل مغلق بـ 12 نقطة، والموديل اللي بيدخل لابتوبك وراه بـ 24 نقطة. قراية منشورة في سبتمبر على إصدار أقدم من المؤشر كانت حاطة الفرق 6 نقط بس، فالرقم بيتغير مع كل تحديث للمؤشر وكل release جديد. احنا عامة بناخد الاتجاه مش الرقم لأنه غالبًا مش بنعيد ال Benchmark setup اللي بيدينا النتائج دي.
بشكل عام بنشوف إننا لو استخدمنا النموذج المفتوح عن طريق مزود خدمة فهنلاحظ فرق في الأداء عن استخدامنا لل Frontier Model و لو شغلنا النموذج المفتوح علي الجهاز الشخصي فهناخد كمان أداء أقل
.
لكن هل دا معناه إن النموذج المفتوح غير مفيد؟ قطعًا لاء لأن بالفعل النماذج دي قادرة علي إنجاز مهمات كثيرة وفرق السعر بينها وبين ال Frontier كبير بدرجة تخلينا نلجأ ليها في أوقات كثير
حتي لو أنت لو بتستخدم Frontier Model في شركتك بالفعل، فاحنا شايفين إن أيام العز و ال Usage limits المفتوحة اللي الشركات وفرتها لموظفيها في مرحلة تبني ال AI ابتدت تنتهي وشركات كتير بتفرض علي موظفيها حاليًا Daily Quota طيب لو خلصتها هعمل ايه؟ هنا ممكن مع تبنينا لل Open Weights نعمل Fallback لنسخ أقل قدرة ولكنها لازالت قادرة تساعدني وتسرع شغلي خلال يوم العمل خصوصًا لو أجزاء تنفيذية فقط، الشاهد مش عاوزين نعطل عشان مش معانا Tokens ^^
الموديلات المفتوحة بتكسب السباق فين؟
السعر. Qwen3.8-27B المستضاف على Qwen Cloud بـ 0.50 دولار للـ input و 3 دولار للـ output لكل مليون token، و DeepSeek V4 Flash بـ 0.14 و 0.28 دولار. الموديلات من فئة Opus مثلاً بـ 5 و 25 دولار. فمحور السعر مهم جدًا وبيفرق مع فئات كبيرة من المستخدمين.
الخصوصية. لو الشركة مانعة إن الكود يتبعت لأي API خارجي، المحلي هو الحل الوحيد.
مفيش vendor lock-in. نفس الموديل عند أكتر من مزوّد، وتقدر تنقله لسيرفراتك بعدين.
المهام الكتير والبسيطة. تصنيف، استخراج بيانات، تلخيص: موديل متوسط بيكفي والتكلفة شبه صفر لكل token.
والـ frontier لسه بيكسب فين؟
المهام اللي محتاجة reasoning عميق أو spec غامض.
الشغل على repo كبير وملفات كتير.
الجلسات الطويلة اللي الـ agent بيشتغل فيها لوحده بالساعات.
النصيحة العملية: لو اشتراكك الحالي مغطي شغلك ومفيش قيود علي موضوع الخصوصية، مفيش سبب تنقل. جرّب المفتوح كـ "طبقة رخيصة" للمهام الروتينية، وسيب الـ frontier للتخطيط والـ debugging الصعب.
جودتها كـ Coding Agent قصاد Claude Code و Codex
الموديل المحلي النهاردة زي junior شاطر محتاج توجيه قريب، والـ frontier زي senior فاهم الـ architecture. الفرق مش في كتابة الكود نفسه، الفرق في التخطيط والصبر على الجلسات الطويلة.
الأرقام بتقول ايه؟
دي أرقام من الـ model card بتاع Qwen3.8-27B، يعني من الشركة نفسها، والمقارنة مع Opus 4.6 Max وهو موديل أقدم من الـ frontier الحالي:
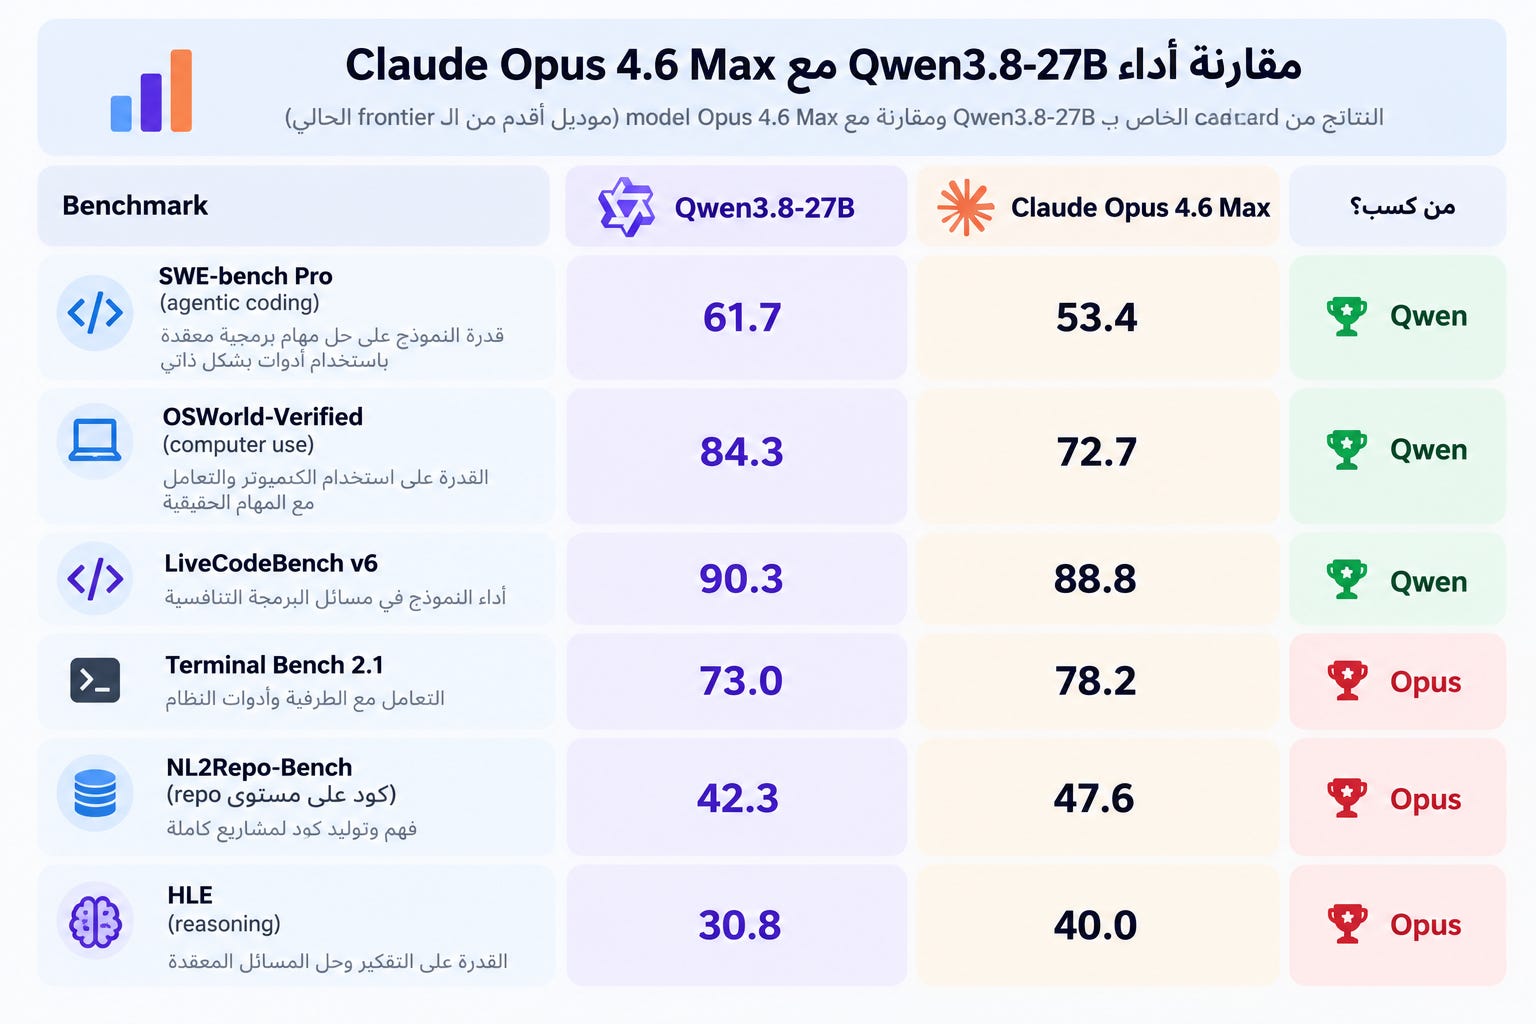
القراءة للترتيب : الموديل الصغير بيكسب في الـ loop القصير (صلّح ده، زوّد ده، شغّل الـ tests) وبيخسر في الـ terminal bench، الشغل على مستوى الـ repo، والـ reasoning العميق.
على جهازك الواقع أقل من الـ benchmark
انت بتشغل نسخة Q4 مضغوطة (Quantization) وبـ context أقصر، والأرقام المنشورة لنسخة كاملة الدقة بـ 256K context. والمراجعات بتقول إن الـ quantization بيأثر على Qwen3.8 أكتر من موديلات تانية.
السرعة هي العائق الحقيقي. الـ agent بيبعت system prompt طويل ومحتوى الملفات مع كل خطوة، وبياخد عشرات الخطوات. اختبار على M5 Pro 48GB سجّل 51 ثانية قبل أول token عند 16K context.
الـ overthinking. Qwen3.8 بيفكر بـ default عالي. في اختبار Simon Willison رسمة SVG واحدة خدت 21 دقيقة و 22,276 reasoning token. الحل: نزّل reasoning_effort لـ medium أو low.
سرعة الكتابة المبلّغ عنها: 16 token/s على MacBook Air M5 32GB، و 15 لـ 30 على M5 Max، وحوالي 48 على RTX 4090. المراجعات بتنصح بأكتر من 30 token/s علشان شغل الـ agent يبقى مريح.
لكنه بينجح جدًا في:
شرح كود وكتابة unit tests
يعمل Refactoring لملف أو اثنين
تنفيذ feature متخطط لها من قبل
يعمل loop لتصليح tests و scripts
الموديل المحلي مش بديل كامل لـ Claude Code أو Codex قصاد الـ frontier الحالي. هو “طبقة تنفيذ” كويسة للشغل المحدد، والـ frontier يفضل الـ architect. والموديلات المفتوحة العملاقة عن طريق API (GLM-5.3، Kimi K3، DeepSeek) أقرب بكتير للـ frontier في الـ coding، وبتشتغل جوه نفس الأدوات.
💻 تحبوا نعمل جزء تاني عن تشغيل نماذج الذكاء الاصطناعي Locally؟

بفضل الله أصبح متاح حالياَ دعمنا من خلال الرعاة والشراكات وفعلنا الـ Sponsorship, بنرحب بجميع الشراكات مع المؤسسات والشركات وأصحاب الأعمال لبناء مجتمع عربي يشجع على القراءة والتعلم ومشاركة التجارب والخبرات العملية في هندسة البرمجيات.
دورك كشريك أو راعي هيكون محوري في دعم المحتوى وتوسيع نطاق تأثيره. فانضم لرحلتنا وكن جزءًا من صناعة مستقبل التكنولوجيا في المنطقة 🚀

تقدروا تشوفوا التفاصيل كاملة من هنا والـ Analytics بتاعتنا من خلال اقرأ-تِك والنشرة الأسبوعية 👇
